Quand une application web plante un soir de forte affluence, le réflexe classique consiste à redémarrer le serveur. Avec un cluster Kubernetes, ce redémarrage se fait tout seul, sur une autre machine, sans intervention humaine. Un cluster K8s regroupe plusieurs machines qui collaborent pour exécuter et surveiller des applications empaquetées dans des conteneurs.
Conteneurs et orchestration : pourquoi un cluster Kubernetes existe
Un conteneur, c’est un paquet logiciel léger. Il embarque le code d’une application, ses dépendances et sa configuration. Contrairement à une machine virtuelle complète, il démarre en quelques secondes et consomme peu de ressources.
A voir aussi : Les coordonnées bancaires sont-elles des informations sensibles ?
Le problème arrive quand vous gérez des dizaines, puis des centaines de conteneurs. Qui décide sur quelle machine chaque conteneur tourne ? Qui relance un conteneur tombé en panne ? C’est le rôle de Kubernetes : orchestrer automatiquement le placement, la mise à l’échelle et la supervision de tous ces conteneurs.
Le cluster est l’unité de base de cette orchestration. Sans lui, Kubernetes n’a nulle part où travailler.
Lire également : Quel est l'intérêt de l'algorithme ?
Architecture d’un cluster K8s : plan de contrôle et noeuds de travail
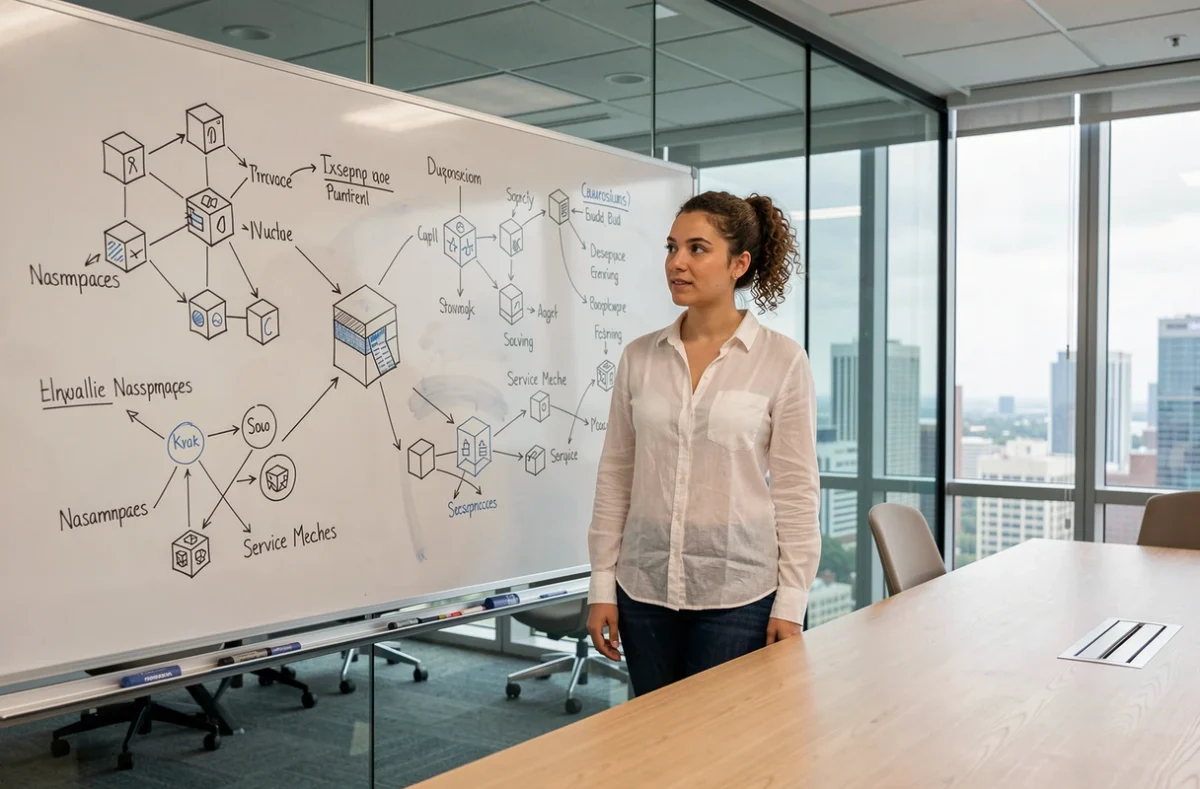
Un cluster Kubernetes se compose de deux grandes parties. La première, le plan de contrôle, prend les décisions. La seconde, les noeuds de travail, exécute les conteneurs.
Le plan de contrôle
C’est le cerveau du cluster. Il contient plusieurs composants, chacun avec un rôle précis :
- Le serveur API (kube-apiserver) reçoit toutes les requêtes, qu’elles viennent d’un administrateur via kubectl ou d’un autre composant interne. C’est le point d’entrée unique du cluster.
- L’ordonnanceur (kube-scheduler) choisit sur quel noeud chaque conteneur va tourner, en fonction des ressources disponibles (mémoire, CPU, voire GPU).
- Le gestionnaire de contrôleurs surveille en boucle l’état réel du cluster et le compare à l’état souhaité. Si un conteneur manque, il en relance un.
- La base de données etcd stocke toute la configuration et l’état du cluster. Sans elle, le plan de contrôle perd la mémoire.
Les noeuds de travail
Ce sont les machines (physiques ou virtuelles) qui font tourner vos applications. Chaque noeud embarque un agent appelé kubelet. Le kubelet reçoit les instructions du plan de contrôle et s’assure que les conteneurs demandés sont bien lancés.
Un autre composant, le kube-proxy, gère le réseau sur chaque noeud. Il dirige le trafic réseau vers le bon conteneur, même si celui-ci a changé de machine entre-temps.
Pods, services et kubectl : le vocabulaire du quotidien
Kubernetes n’exécute pas directement un conteneur isolé. Il le place dans un pod, la plus petite unité déployable du cluster. Un pod contient un ou plusieurs conteneurs qui partagent le même réseau et le même espace de stockage.
Pourquoi cette couche supplémentaire ? Parce que certains conteneurs ont besoin de communiquer très étroitement, par exemple un serveur web et un agent de journalisation. Le pod les regroupe sur le même noeud, avec la même adresse réseau interne.
Un service Kubernetes expose un groupe de pods vers le reste du cluster ou vers l’extérieur. Les pods peuvent être détruits et recréés sur d’autres noeuds, mais le service conserve une adresse stable. Les utilisateurs ne voient aucune interruption.
Pour piloter tout cela, l’outil en ligne de commande kubectl envoie des instructions au serveur API. Créer un déploiement, vérifier l’état des pods, consulter les journaux : kubectl est l’interface quotidienne de l’administrateur.
Cluster Kubernetes et gestion des ressources IA : au-delà de l’exécution classique
Un cluster K8s servait à l’origine à faire tourner des applications web et des microservices. Cette mission reste centrale, mais le périmètre a changé. Les charges liées à l’intelligence artificielle imposent des contraintes nouvelles.
Les modèles d’IA consomment des GPU, pas seulement du CPU et de la mémoire. Les versions récentes de Kubernetes intègrent un mécanisme appelé Dynamic Resource Allocation, qui attribue finement les accélérateurs matériels (GPU, TPU) aux pods qui en ont besoin. L’ordonnanceur ne se contente plus de répartir de la mémoire : il gère des ressources spécialisées et coûteuses.
Autre évolution notable : la mise à l’échelle jusqu’à zéro. Dans Kubernetes 1.37, le Horizontal Pod Autoscaler supporte le scale-to-zero en version bêta, activé par défaut. Concrètement, un service d’inférence IA qui ne reçoit aucune requête peut voir ses pods réduits à zéro, ce qui supprime la consommation de ressources GPU pendant les périodes d’inactivité.
Ces fonctionnalités transforment le cluster. Il ne se limite plus à lancer et relancer des conteneurs. Il devient une plateforme d’allocation de ressources rares, avec un impact direct sur les coûts d’exploitation.
Cycle de vie d’un cluster K8s : ce que la maintenance implique
Monter un cluster est une chose. Le maintenir en conditions opérationnelles en est une autre. Kubernetes publie plusieurs versions par an, et chaque montée de version du plan de contrôle doit précéder celle des noeuds de travail.
Les composants périphériques ajoutent de la complexité. Par exemple, Flannel, un plugin réseau historique très répandu dans l’écosystème, arrive en fin de vie à partir de Kubernetes 1.36. Les équipes qui l’utilisent doivent migrer vers une autre solution réseau avant de mettre à jour leur cluster. Ce type de dépendance externe est souvent sous-estimé lors du dimensionnement initial.
La sécurité évolue aussi vers des exécutions sans privilèges élevés, ce qui oblige à revoir la configuration de nombreux pods existants. Un cluster en production demande une maintenance continue, pas seulement un déploiement initial.
L’état souhaité du cluster (quels pods tournent, combien de réplicas, quelles limites de ressources) est déclaré dans des fichiers de configuration. Kubernetes compare en permanence cet état souhaité à l’état réel et corrige les écarts. Ce mécanisme déclaratif simplifie la gestion au quotidien, mais suppose que les fichiers de configuration soient versionnés et audités avec la même rigueur que le code applicatif.
Un cluster Kubernetes reste un outil, pas une solution magique. Sa puissance vient de l’automatisation de tâches fastidieuses : placement des conteneurs, redémarrage après panne, répartition du trafic réseau. Sa complexité vient du nombre de composants à coordonner et de la cadence des mises à jour. Bien dimensionner son cluster dès le départ évite des surcoûts liés à des ressources inutilisées ou à des migrations précipitées.